LiveVLM: Efficient Online Video Understanding via Streaming-Oriented KV Cache and Retrieval
Background
VLM 典型的 workflow 是离线的:
- 接受 user query 以及一段完整的视频;
- 将视频处理成 vision tokens,加到 user query 中;
- 输出结果。
在线场景与之不同,其:
- 在 query 到达前不断处理到来的 video frame;
- 收到 query 后,实时地生成答案。
三个挑战:
- 视频理解,处理视频帧产生大量 KV,为节省资源利用 sparsity 则必须考虑质量损失的问题;
- 内存开销,同上;
- 实时相应速度,不能在 query 到达后才一次性处理视频帧,这样会带来巨大时延。
Motivation
现有工作试图解决内存开销与时延问题:
- query-dependent 方法,即根据当前特定的查询保留与当前查询相关的 token,这要求在查询到来后再进行 KV 压缩,响应慢,另外这些 token 只对当前查询有用,后续查询可能会用到一些被丢弃的 token,质量也不行;
- query-agnostic 方法,查询到来前即进行 KV 压缩,比方说将完整的 KV 卸载到 CPU,或者在固定内存预算下丢弃一些 KV,都有各自的缺点。
Design
Vision Sink Bucketing
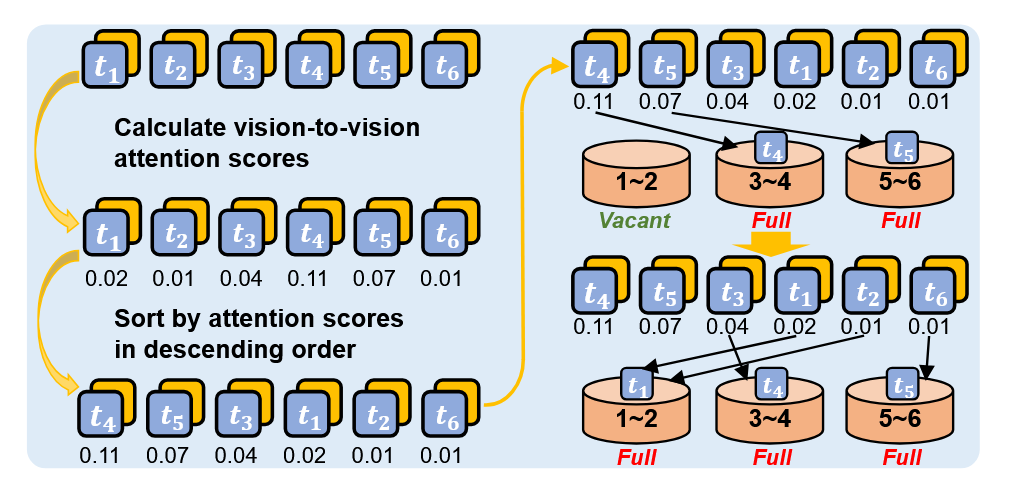
- 流式地处理 video frame,使用最近窗口内的 vision token 对其他已缓存 vision token 的 vision-to-vision score 计算出这些 token 的重要性分数;
- 将 cache 预算按上下文分桶,先按照上述重要性分数贪心地保留一定比例的 token,当且仅当各桶内预算足够才填入,然后将剩下的未满的桶也按重要性分数填满,此举是为了避免只将最近的 token 填入 cache,增强长程能力。
Position-agnostic Retrieval
不能直接将 cache 里所有的 token 都应用到新查询中,所以进行检索,现有的查询方法是 page-level 的,即将 KV cache 分页,从每页中计算出代表 tensor 来计算和 query 的相关性。但这对压缩后的 cache 影响较大,因为压缩后的 cache 的 Positional Embedding 信息是不连续的,比方说一个页内的 token 顺序可能是 1 8 17 34...这会破坏代表 tensor 的代表能力,因此设计 PaR 方法: 1. 移除 cache 中 key tensor 的 PE,计算每页的代表 tensor; 2,计算代表 tensor 与 query 的相似性选出最相关的数页; 3. 还原 PE,将这些页的 tensor 与最近窗口内的 tokens 作为输入。

Evaluation
- 基础模型:LLaVA-OneVision-Qwen2-7B-OV
- 硬件:NVIDIA 4090D
- 超参:缓存预算 M=12k;bucket 容量 B=1;page 大小 C=16;检索比例 40%
质量表现
在不进行 offload KV cache 到 CPU 的条件下,LiveVLM 报出了最高准确率与分数(GPT打分)。
开销表现
