ZipMoE: Efficient On-Device MoE Serving via Lossless Compression and Cache-Affinity Scheduling
地址:https://arxiv.org/pdf/2601.21198
作者: 南京大学,周志华组
Background
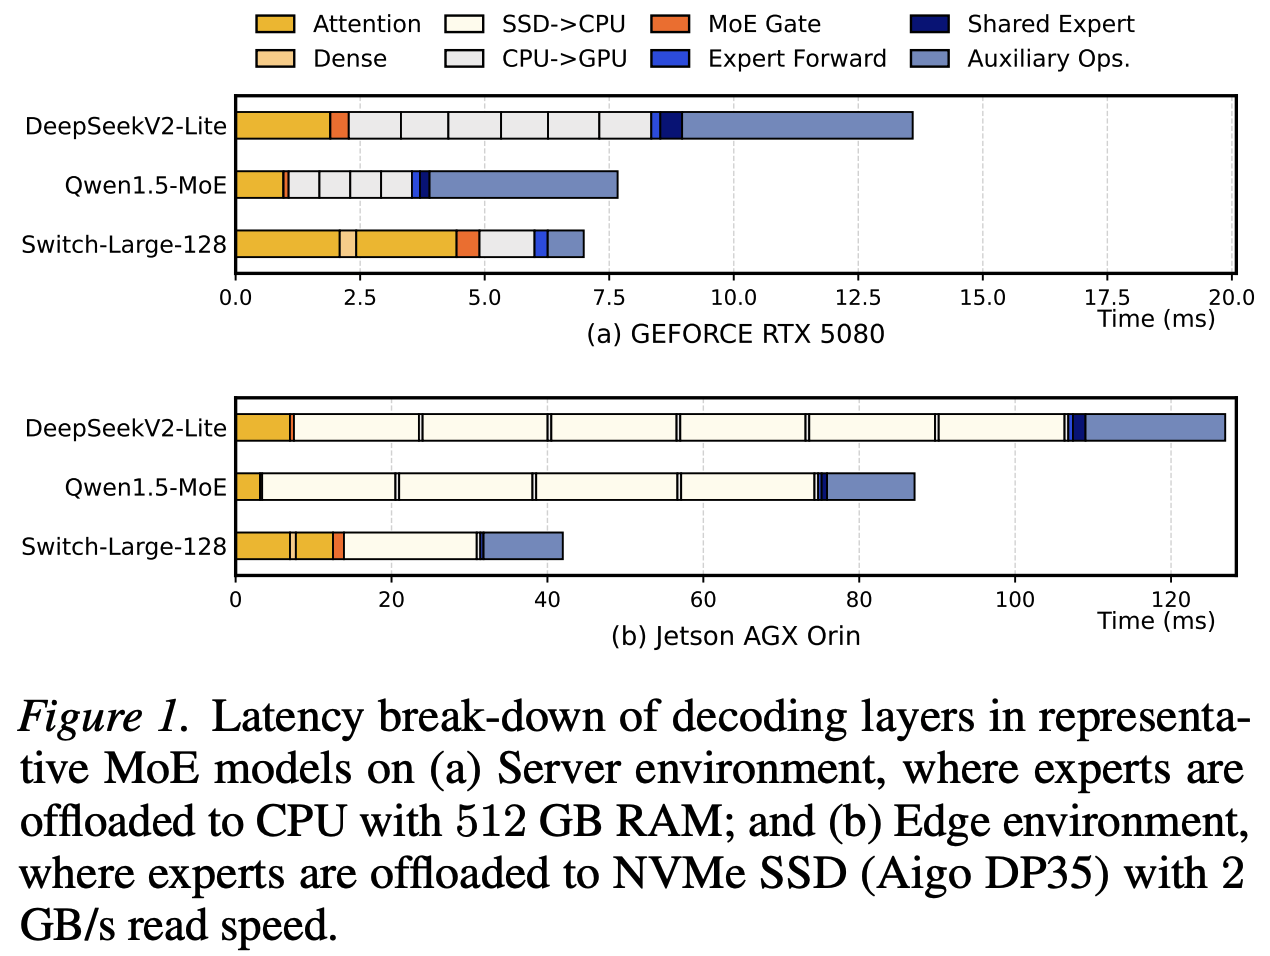
云端的MoE Serving System并不适配端侧的情况,例如下图(a)表示云端的 LLM serving 的情况,(b)表示端侧的 LLM serving 的情况,可以看到,在端侧由于模型文件无法完全加载到 dram,所以其I/O stall 的时间从 38.5%(云) 增长到 80.1%(端),并且对于端侧 one-batch 的场景,无法用 pipeline 技术来 overlap I/O 时间
Motivation
BF16 的 16 bit 信息量并不均匀
对于一个 BF16 格式的 MoE 模型,其每个数据组成为 [sign:1][exponent:8][mantissa:7],这里有个重要统计现象: sign + mantissa 基本接近随机,压不动;但 exponent 分布高度集中,非常好压缩。
测试三个 MoE,exponent 的 Shannon entropy 只有大约:2.5bits,也就是说可以: - SM-chunk = sign + mantissa,8 bit,直接原样保存; - E-chunk = exponent,8 bit,使用 LZ4HC/ZSTD lossless compression。 理论上使用压缩算法后,模型可以压缩到:LZ4HC:74%/ZSTD:68%
解压缩的时间是否可以被 overlap?
理论上,I/O时间会减少,但是随之而来 CPU 的解压时间又在 critical path 上
经过测试,在 Jetson AGX Orin 上,只需要大约 3 个 CPU worker,LZ4HC/ZSTD 解压 exponent 的速度就已经比 SSD 读取等量原始数据快。
一个 overlap 的机会:原来的 expert需要完整读取 SM(50%)+E(50%),但是现在是读取 SM(50%)+CompressedE(17%),同时多一个 DecompressE 的操作在 CPU 上并行
Design
文章中相较于原先的 expert 粒度的 MoE 推理的 cached/uncache 两种状态,定义出了 4 种状态进行调度
| 状态 | RAM 中有什么 | 运行时需要做什么 |
|---|---|---|
| Full expert (F) | 完整 BF16 | 直接执行 |
| Compressed expert (C) | SM + compressed E | CPU 解压 E + reconstruct |
| SM-expert (S) | SM | SSD 读 compressed E + 解压 |
| E-expert (E) | compressed E | SSD 读 SM,同时解压 E |
| Miss | 什么都没有 | SSD 读 SM + E,再解压 |
具体调度方案见 paper 中
需要思考的问题
- 本 Paper 的 contribution:既然 weights 可以分成 compressible 和 incompressible 两部分,就不要再把 expert 当成 cache 的原子单位。传统:Expert={cached,miss}; ZipMoe: Expert={F,C,S,E,Miss},从而得到了新的memory management 和 scheduling 方案
- Energy 问题,本文将权重进行了 split,并且引入了新的 compress 操作,该操作进一步引入了CPU 的使用,这会造成明显的能耗的上升
- 文章中的 baseline 表现极差,其对比了 MoE-infinity,DeepSpeed,FineMoE,虽然有这么多,但是 baseline在UMA 上适配非常差,导致其 baseline 的Qwen1.5-MoE 14B decode 吞吐在 1token/s 以下。并且,ZipMoE Qwen1.5-MoE 14B的表现也没有那么好,也就 2-5token/s
- 本文的实验平台只有 jetson 设备,并没有手机端